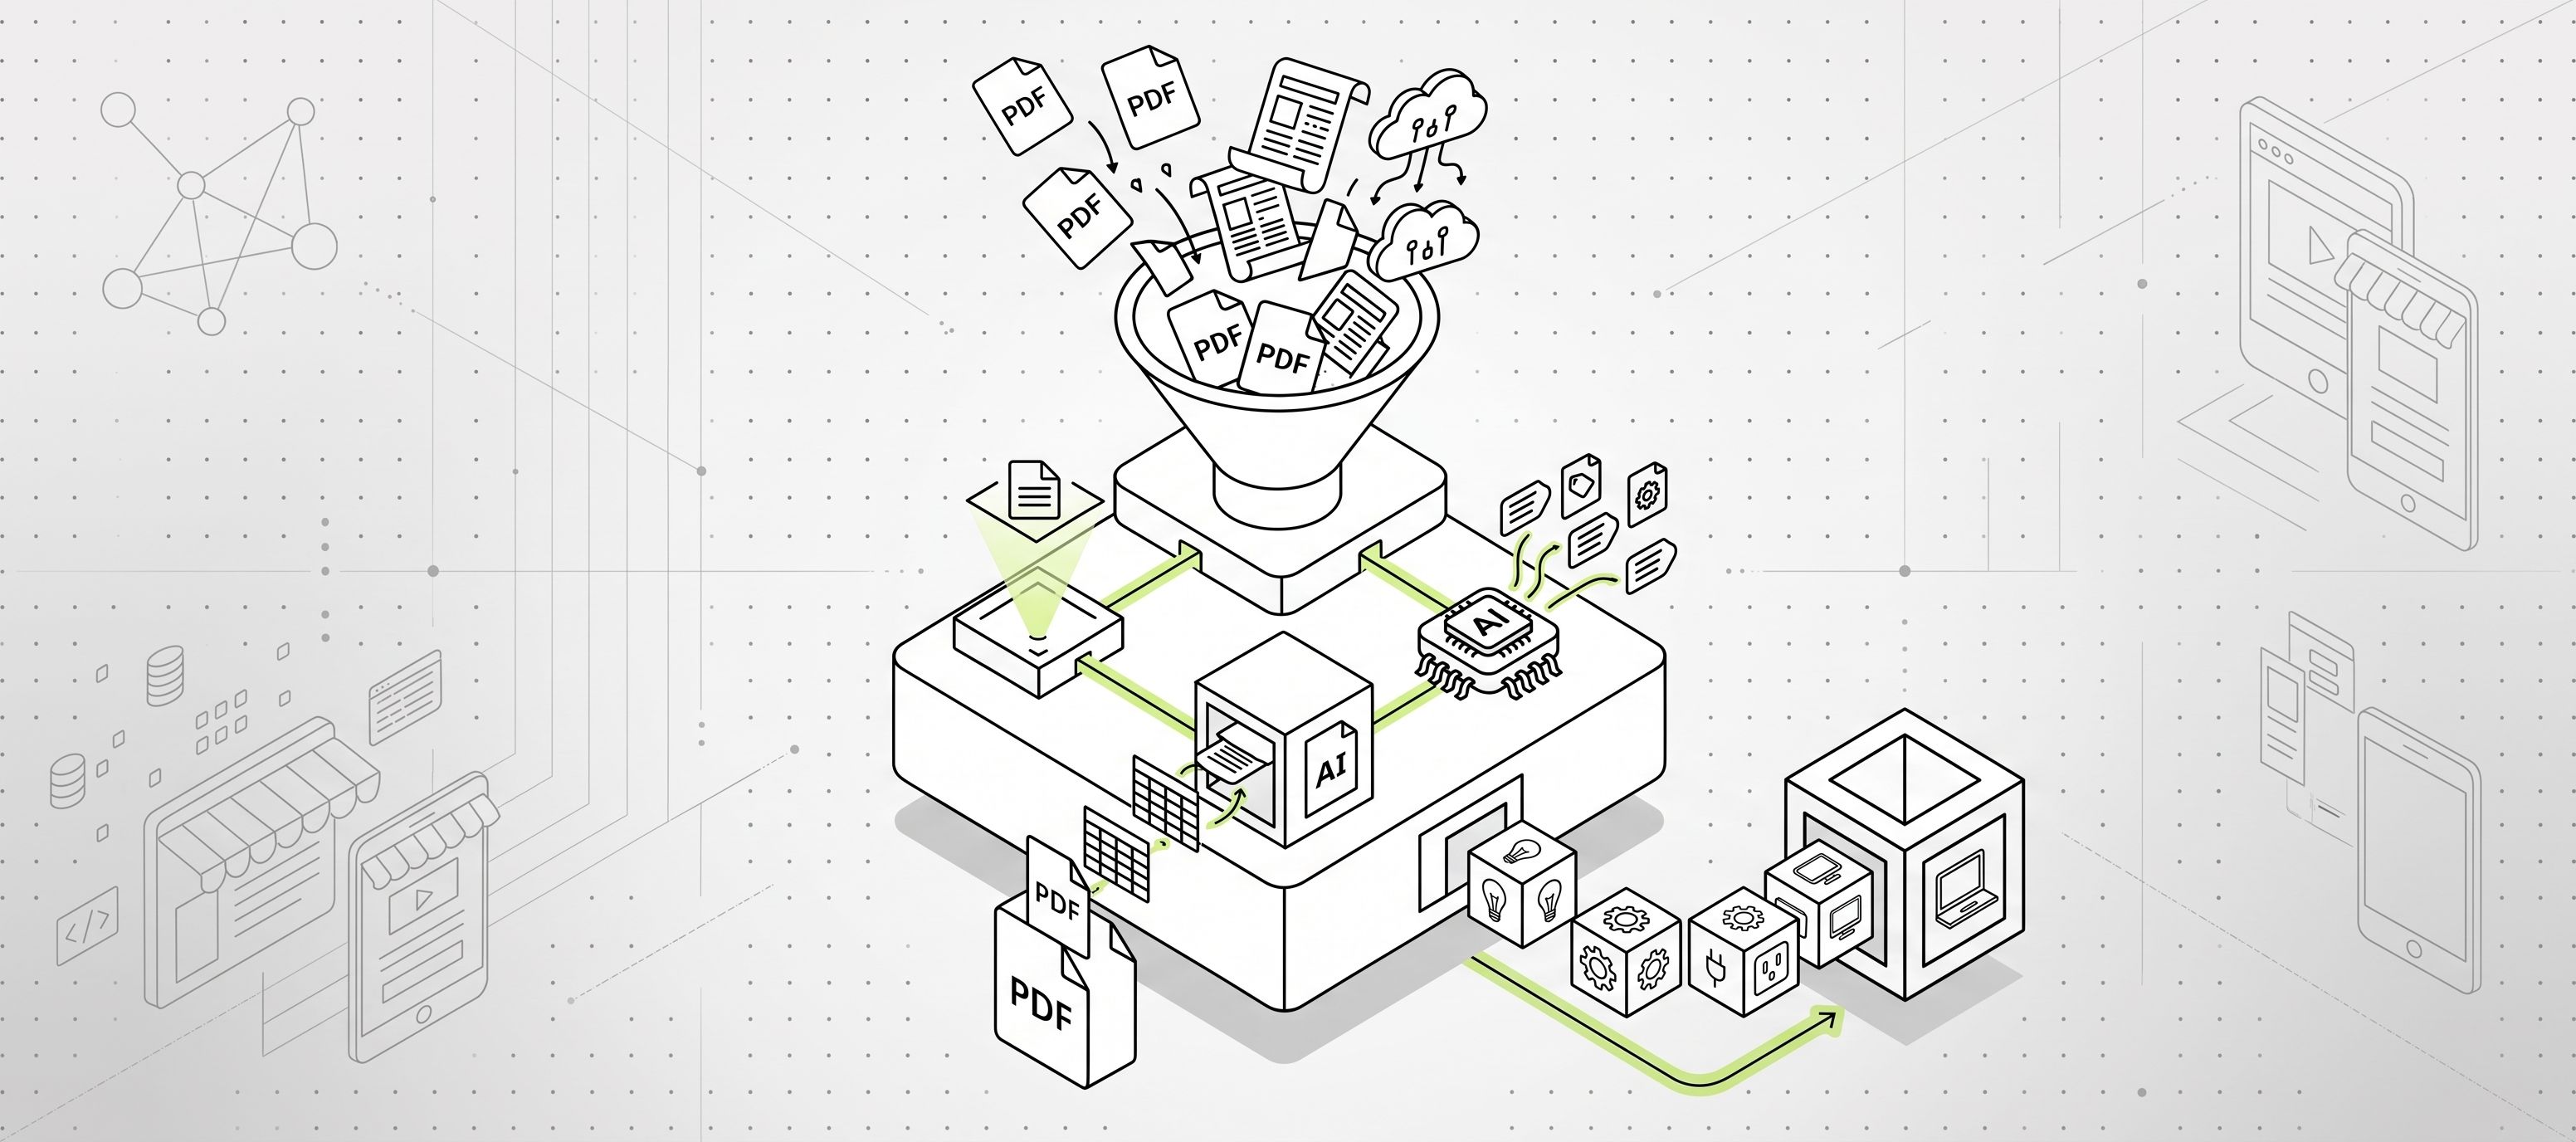
U trzech różnych klientów z różnych branż to nie wybór platformy okazał się najdroższym i najbardziej blokującym elementem wdrożenia, tylko stan danych produktowych. Dane źródłowe leżą w PDF-ach od dostawców, w papierowych katalogach i w głowach handlowców, a firmy nie mają zasobów, żeby przepisać je ręcznie. Ekstrakcja danych z dokumentów, OCR i wzbogacanie ich przez AI potrafią zamienić tygodnie takiej pracy w dni. Ten artykuł pokazuje, jak to wygląda w praktyce i co sprawdzić, zanim zaczniecie wdrożenie.
Dlaczego dane produktowe kosztują więcej niż wybór platformy?
Firma planująca wdrożenie e-commerce albo PIM zwykle zaczyna od wyboru platformy i dostawcy, a dane produktowe traktuje jako coś, co „się jakoś zaimportuje” na końcu. W projektach, przy których pracujemy, jest odwrotnie. U trzech różnych klientów z różnych branż najdroższym i najbardziej blokującym elementem wdrożenia nie była platforma, tylko dane produktowe.
Jeden klient płaci nam osobno za samą ekstrakcję danych z PDF-ów dostawców. Drugi uzależnił cały POC agenta AI od tego, czy dane są zgodne ze standardem ETIM i czy OCR poprawnie odczytał skany kart produktowych. Trzeci zamówił osobne narzędzie AI do mapowania, walidacji i wzbogacania danych, które spływają z wielu źródeł naraz. W żadnym z tych trzech przypadków rozmowa nie zaczęła się od pytania o platformę.
Gdzie faktycznie leżą wasze dane produktowe?
Rzadko leżą tam, gdzie firma by chciała: w jednym, gotowym pliku eksportu. Zwykle są rozproszone po trzech miejscach naraz. Część danych siedzi w PDF-ach od producentów i dystrybutorów: kartach katalogowych, cennikach, specyfikacjach technicznych, czasem tylko zeskanowanych. Część leży w papierowych albo elektronicznych katalogach, które nigdy nie miały ustandaryzowanego formatu. Reszta istnieje wyłącznie w głowach handlowców, którzy latami uczyli się, który parametr jest dla klienta istotny i jak go opisać.
Zwykły import CSV zakłada, że dane już czekają w uporządkowanej tabeli. Kiedy dane produktowe faktycznie leżą w tych trzech miejscach, ten krok trzeba dopiero wykonać, zanim jakikolwiek import ma sens – to dokładnie ten etap pokrywa integracja Magento z systemami PIM, czyli scentralizowanie danych produktowych spływających od dostawców i producentów.
Co robią ekstrakcja, OCR i wzbogacanie danych przez AI?
To trzy osobne kroki, które często się ze sobą myli. Ekstrakcja danych z PDF-ów wyciąga strukturalne informacje z dokumentów, które mają jakąś powtarzalną strukturę: tabele parametrów, sekcje specyfikacji. OCR wchodzi do gry tam, gdzie dokument jest w praktyce obrazem, nie tekstem, czyli przy zeskanowanych kartach katalogowych: bez niego nie ma czego mapować, bo strona to dla systemu jeden duży rysunek.
Dopiero po tych dwóch krokach zaczyna się wzbogacanie danych przez AI: uzupełnianie brakujących opisów, tłumaczenie nazewnictwa producenta na wewnętrzny słownik atrybutów, sprawdzanie zgodności ze standardem branżowym tam, gdzie firma go używa. To jest dokładnie ten zestaw kroków, za który jeden z naszych klientów płaci jako za osobne narzędzie, nie jako za dodatek do wdrożenia platformy.
Ile czasu to realnie oszczędza?
Z naszego doświadczenia to, co ręcznie zajmuje tygodnie, przy dobrze poskładanej ekstrakcji, OCR-ze i wzbogacaniu przez AI da się zamknąć w dni, a nie tygodnie. Różnica bierze się stąd, że ręczne przepisywanie skaluje się liniowo z liczbą produktów, a raz zbudowany proces ekstrakcji i mapowania działa tak samo szybko dla stu, jak i dla dziesięciu tysięcy pozycji.
Dane produktowe to warunek wdrożenia
Wybór platformy jest decyzją, którą podejmuje się raz. Stan danych produktowych trzeba sprawdzać przy każdym nowym dostawcy, każdej aktualizacji katalogu i każdym nowym rynku, na który firma wchodzi. Jeśli ten temat zostanie potraktowany jako coś, co „samo się zaimportuje”, wraca dokładnie w momencie, w którym najbardziej szkodzi, czyli w trakcie samego wdrożenia.
Zanim wybierzecie narzędzie albo dostawcę PIM, sprawdźcie trzy rzeczy:
- Gdzie faktycznie znajdują się wasze dane źródłowe (PDF-y, katalogi, systemy dostawców, wiedza handlowców) i w jakim są stanie.
- Czy potrzebujecie zgodności z konkretnym standardem branżowym (np. ETIM), czy wystarczy wam spójny, wewnętrzny słownik atrybutów.
- Ile z tych danych da się wyciągnąć automatycznie przez ekstrakcję, OCR i AI, a ile i tak będzie wymagało decyzji człowieka po stronie biznesu.
Jeśli rozpoznajecie u siebie ten sam wzorzec, że dane produktowe rozjeżdżają się między PDF-ami, katalogami dostawców i wiedzą handlowców, warto zobaczyć też, jak to samo wygląda po stronie modelu i atrybutów już w systemie: szerzej opisaliśmy to w artykule „Atrybuty produktowe: dlaczego blokują wdrożenie PIM„. Jeśli wolicie od razu porozmawiać o konkretnym przypadku, zobaczcie wdrożenia systemów PIM dla e-commerce B2B.